기술통계와 t검정
모수·통계량과 자료 요약 · 평균과 중앙값 · 분산·표준편차·사분위수
이 차시를 마치면
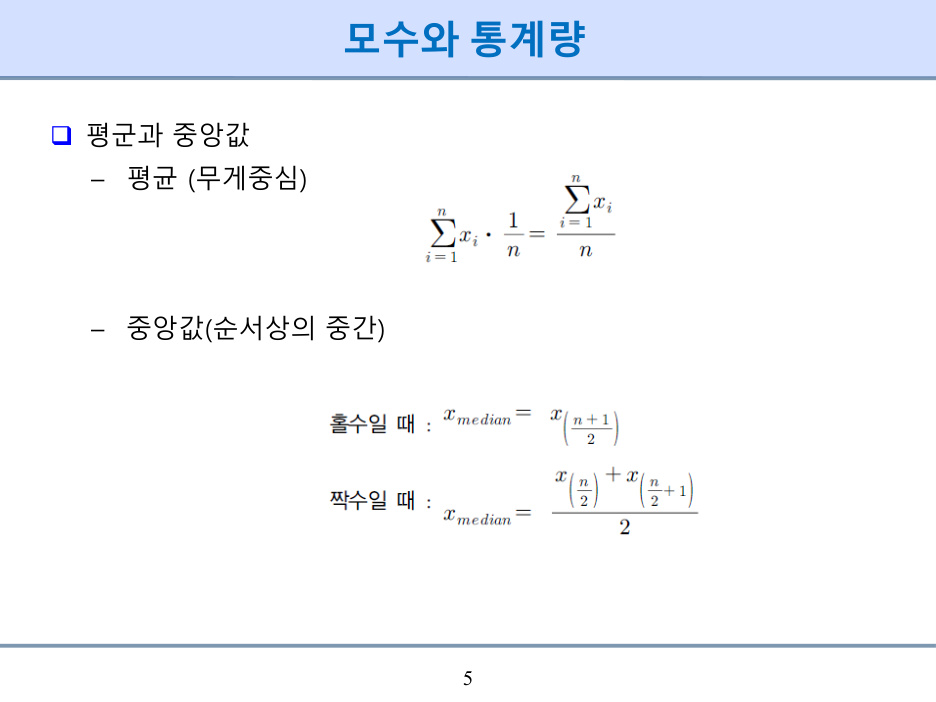
- 평균은 합을 관측값 수 n으로 나눈 값이다.
- 중앙값은 정렬한 자료의 가운데 위치를 기준으로 한다.
- R의 var는 표본분산 계산에서 n−1 분모를 쓴다.
모수·통계량과 자료 요약
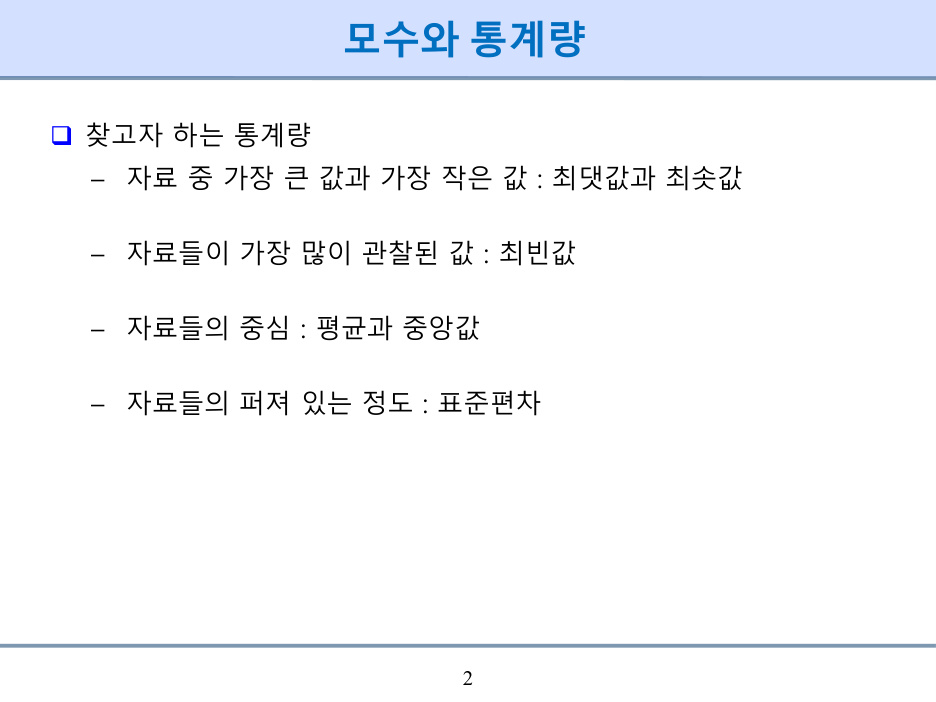
모수는 모집단의 특성을, 통계량은 표본에서 계산한 값을 뜻한다. 최댓값·최솟값은 범위의 끝, 최빈값은 가장 자주 나타나는 값이다.
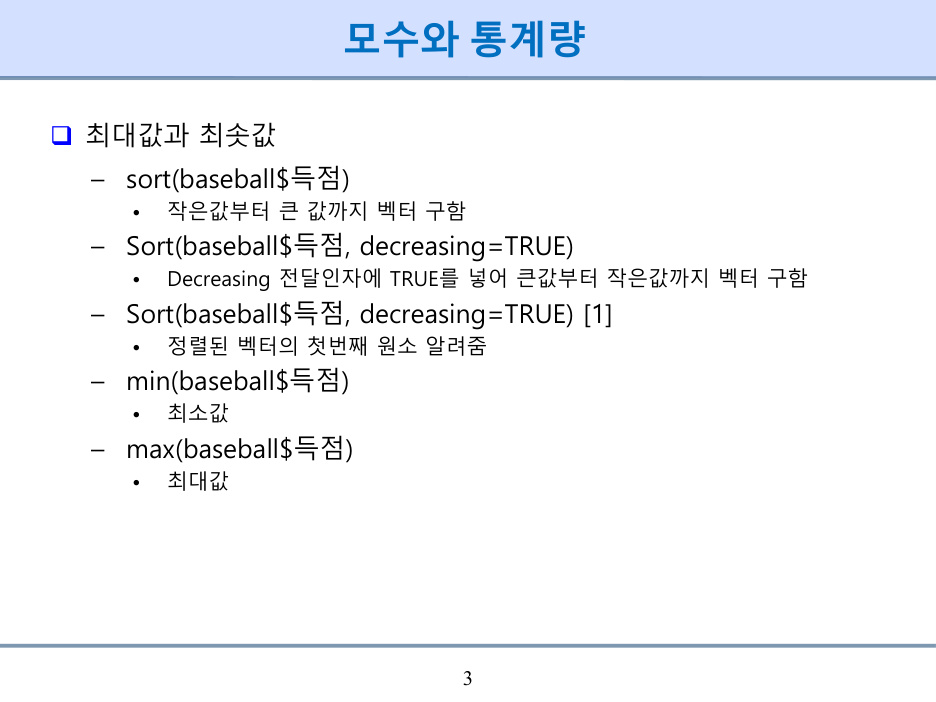
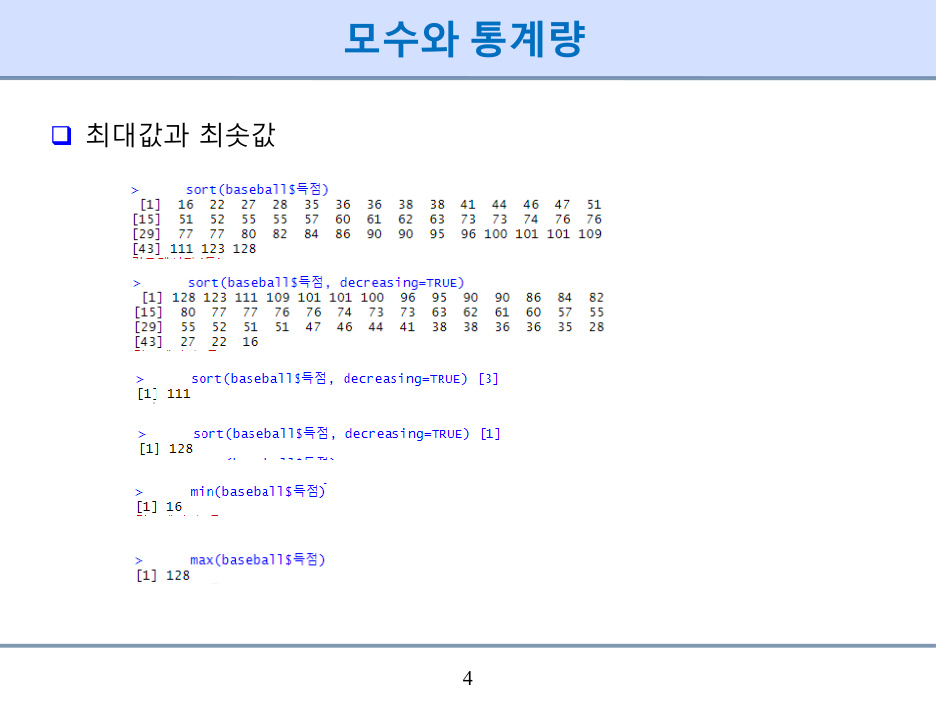
R에서는 sort(a), sort(a,decreasing=TRUE), min(a), max(a)를 사용한다. 내림차순으로 정렬한 결과의 [1]은 최댓값이다. R은 대소문자를 구분하므로 함수 이름은 sort이다.
모수는 Parameter, 통계량은 Statistic, 모집단은 Population, 표본은 Sample이다. Mode는 최빈값, Minimum은 최솟값, Maximum은 최댓값이다. 야구 득점 실습에서 최댓값은 128, 최솟값은 16이며 내림차순 정렬의 [3]은 세 번째 값 111을 고른다.
관련 강의자료 펼치기
data_분석_t_test · PDF 물리 2쪽
data_분석_t_test · PDF 물리 3쪽
data_분석_t_test · PDF 물리 4쪽
관련 영상 00:00:00 (원본 영상 · 로컬 보관)
관련 영상 00:08:30 (원본 영상 · 로컬 보관)
관련 영상 00:09:50 (원본 영상 · 로컬 보관)
평균과 중앙값
평균은 합을 관측값 수 n으로 나눈 값이고, 중앙값은 정렬한 자료의 가운데 값이다. n이 짝수이면 가운데 두 값의 평균을 쓴다.
극단값은 평균을 크게 움직일 수 있지만 중앙값에는 상대적으로 영향이 작을 수 있다. R의 mean(a)와 median(a)로 구하며 분포의 모양과 함께 해석한다.
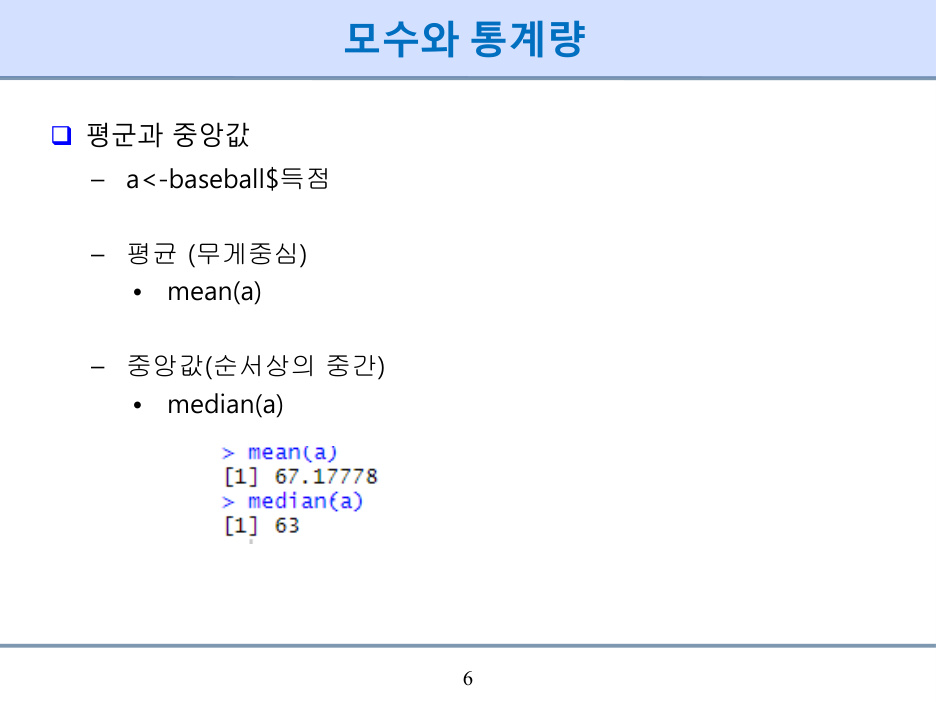
Mean은 평균, Median은 중앙값이다. 야구 득점 실습의 평균은 약 67.17778, 중앙값은 63이다. 같은 자료에서도 중심을 요약하는 방식에 따라 값이 다르다.
관련 강의자료 펼치기
data_분석_t_test · PDF 물리 5쪽
data_분석_t_test · PDF 물리 6쪽
관련 영상 00:01:54 (원본 영상 · 로컬 보관)
관련 영상 00:10:45 (원본 영상 · 로컬 보관)
분산·표준편차·사분위수
표본분산 s²=Σ(xᵢ−평균x)²/(n−1), 표준편차 s=√s²이다. 분산의 단위는 원 단위의 제곱이고 표준편차는 원 단위와 같다. R의 var와 sd는 표본 통계량을 계산한다.
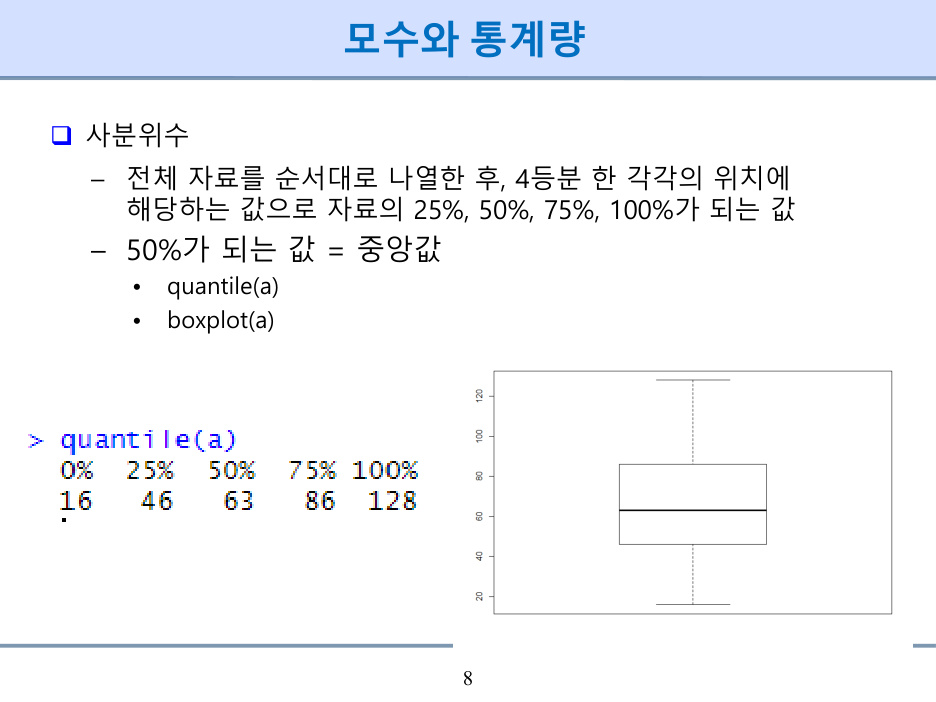
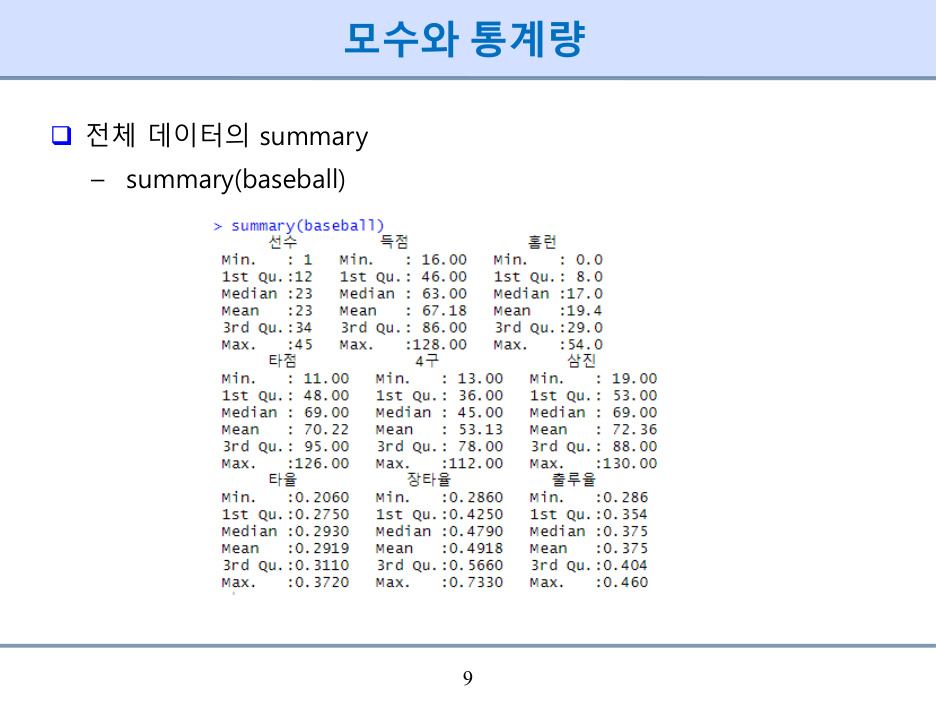
사분위수는 정렬한 분포의 25%, 50%, 75% 위치를 요약한다. quantile(a), boxplot(a), summary(data)로 중심과 퍼짐을 함께 확인한다. 최댓값은 100백분위 위치다.
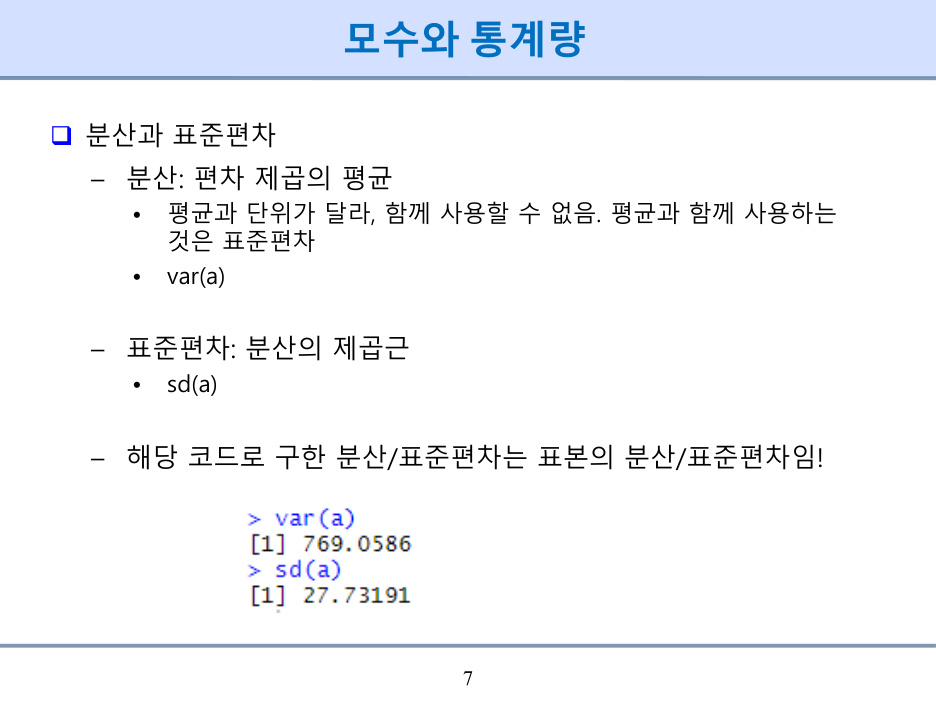
Variance는 분산, Standard Deviation(SD)은 표준편차, Quartile은 사분위수, Quantile은 분위수, Boxplot은 상자그림이다. 실습의 분산은 769.0586, 표준편차는 27.73191이며 최소·1사분위·중앙·3사분위·최대는 16, 46, 63, 86, 128이다.
관련 강의자료 펼치기
data_분석_t_test · PDF 물리 7쪽
data_분석_t_test · PDF 물리 8쪽
data_분석_t_test · PDF 물리 9쪽
관련 영상 00:11:43 (원본 영상 · 로컬 보관)
평균 가설과 세 종류의 t검정
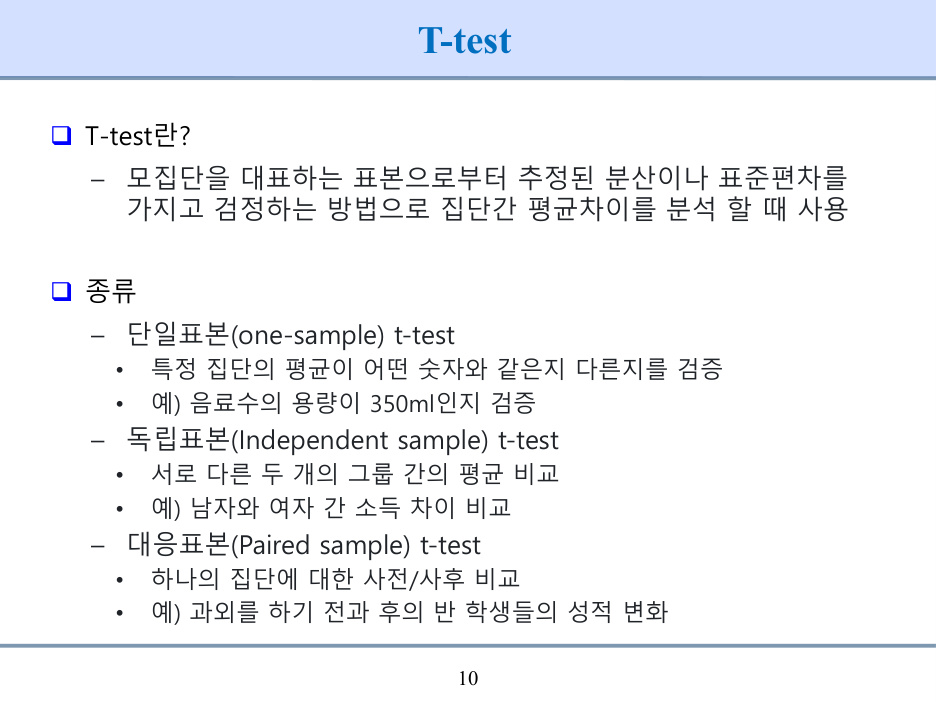
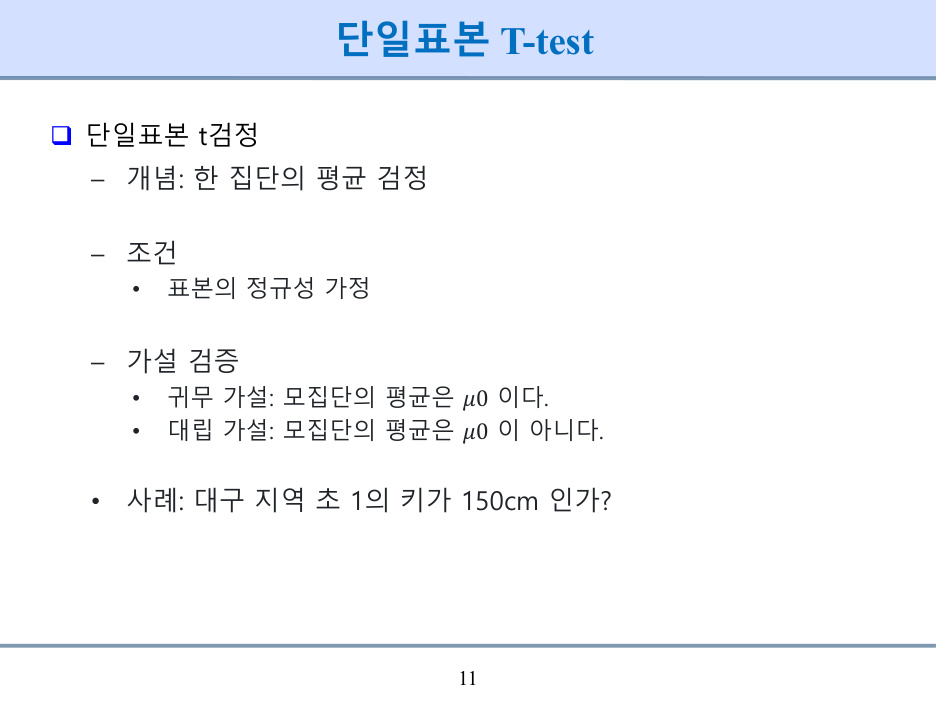
단일표본 t검정은 한 모집단 평균을 기준값 μ₀와 비교한다. 독립표본 t검정은 서로 다른 두 집단 평균을 비교하고, 대응표본 t검정은 같은 대상의 전후 차이를 비교한다.
검정의 종류는 자료 간 관계로 정한다. 평균 차이 검정은 분포 전체가 같은지 검사하는 방법과 다르다. 단일표본 통계량은 t=(표본평균−μ₀)/(s/√n)이다.
One-sample t-test는 음료 용량의 평균이 350 ml인지 비교하는 예, Independent-samples t-test는 서로 다른 집단의 평균 소득을 비교하는 예, Paired-samples t-test는 같은 학생의 과외 전후 성적을 비교하는 예와 연결한다. Null Hypothesis(H₀)는 귀무가설, Alternative Hypothesis(H₁)는 대립가설이다.
관련 강의자료 펼치기
data_분석_t_test · PDF 물리 10쪽
data_분석_t_test · PDF 물리 11쪽
data_분석_t_test · PDF 물리 12쪽
관련 영상 00:16:18 (원본 영상 · 로컬 보관)
관련 영상 00:18:33 (원본 영상 · 로컬 보관)
정규성 점검과 단일표본 검정
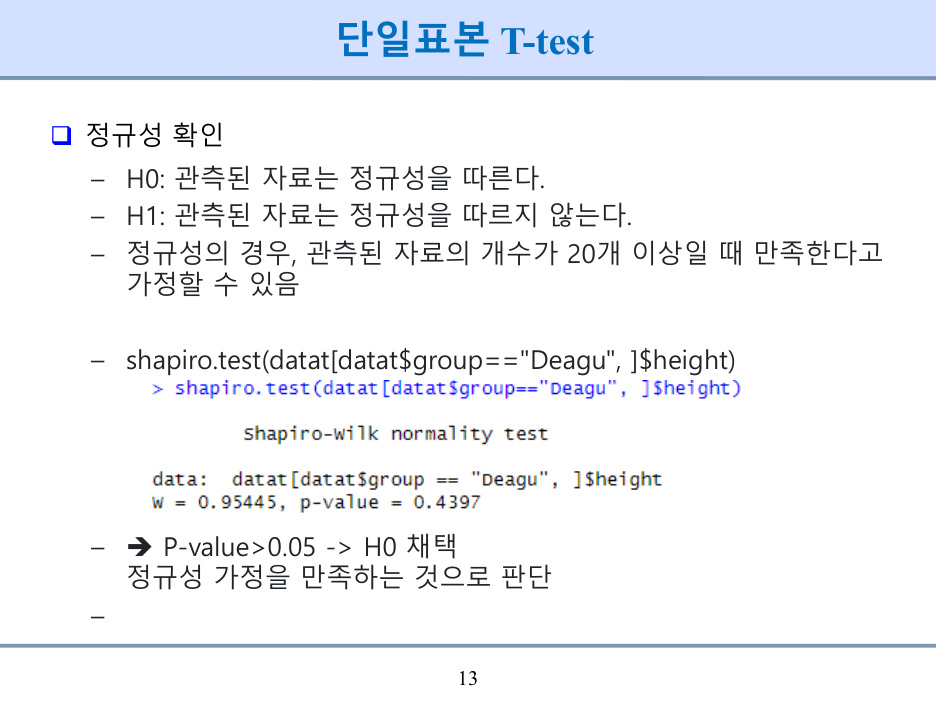
shapiro.test(x)는 정규성 가설을 검토한다. p>.05는 그 유의수준에서 기각할 근거가 부족하다는 뜻이며 정규성을 증명하지 않는다. n이 20을 넘었다는 이유만으로 원자료가 정규분포가 되지도 않는다.
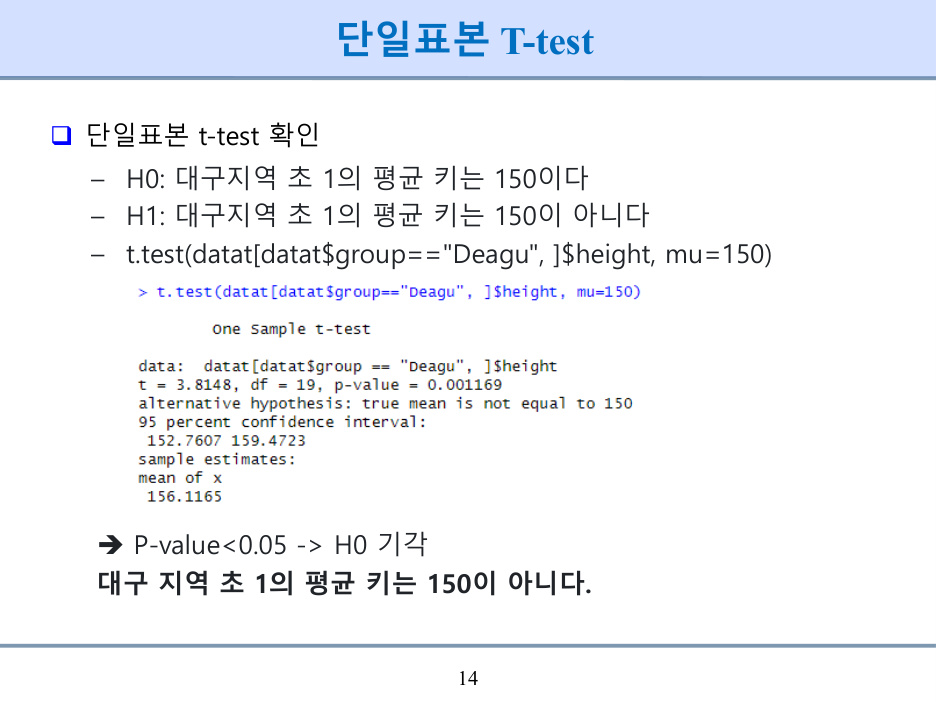
평균 150을 기준으로 비교하려면 t.test(x,mu=150)을 사용한다. mu를 생략하면 기본 비교값은 0이다. 평균차이와 신뢰구간을 p값과 함께 읽는다.
Shapiro–Wilk Test는 정규성 검정이다. 대구 자료 예의 W=.95445, p=.4397은 α=.05에서 정규성 가설을 기각하지 못하는 결과다. 단일표본 mu=150의 결과는 t=3.8148, df=19, p=.001169, 표본평균=156.1165, 95% 신뢰구간=152.7607–159.4723이다.
실습에서 mu에 표본평균 156.1165를 넣으면 t는 거의 0이고 양측 p는 거의 1이 된다. 이는 분자에서 표본평균과 비교값의 차이가 거의 없어지기 때문이다. 관찰한 평균을 사후에 귀무가설 값으로 대입한 시연을 독립적인 연구 가설 검정처럼 해석하지 않는다.
Normality는 정규성, Confidence Interval은 신뢰구간이다. p값만 읽는 대신 비교값과 평균, 신뢰구간, 표본 크기를 함께 확인한다.
관련 강의자료 펼치기
data_분석_t_test · PDF 물리 13쪽
data_분석_t_test · PDF 물리 14쪽
관련 영상 00:23:45 (원본 영상 · 로컬 보관)
관련 영상 00:28:21 (원본 영상 · 로컬 보관)
관련 영상 00:33:38 (원본 영상 · 로컬 보관)
독립표본: Welch와 등분산 검정
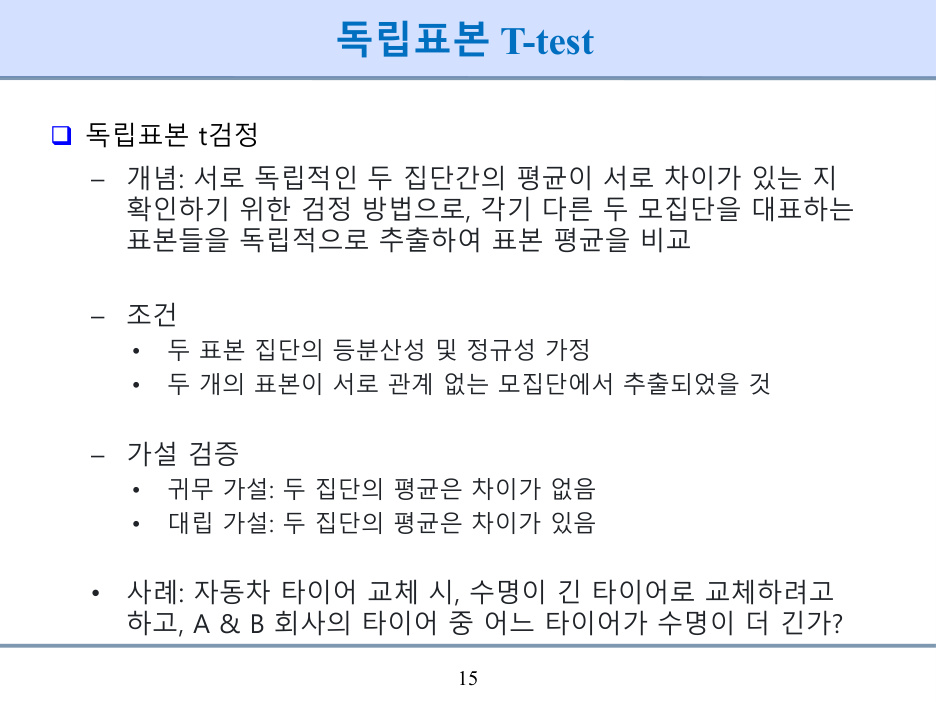
독립표본에서는 집단 사이의 관측이 독립적이어야 한다. 등분산을 가정하는 pooled t검정과 그 가정을 완화한 Welch t검정을 구분한다.
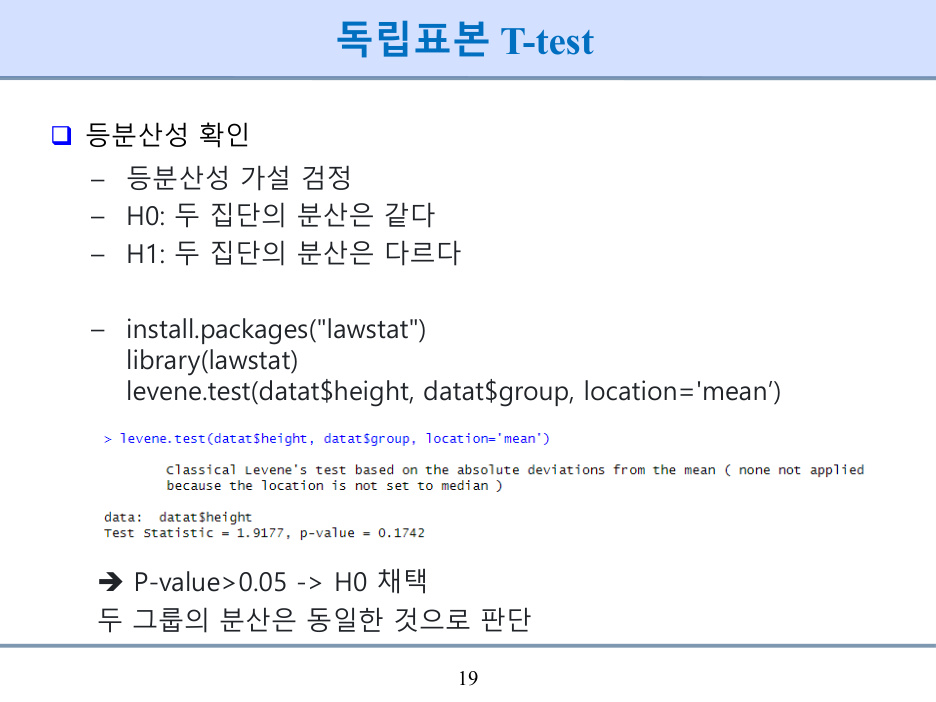
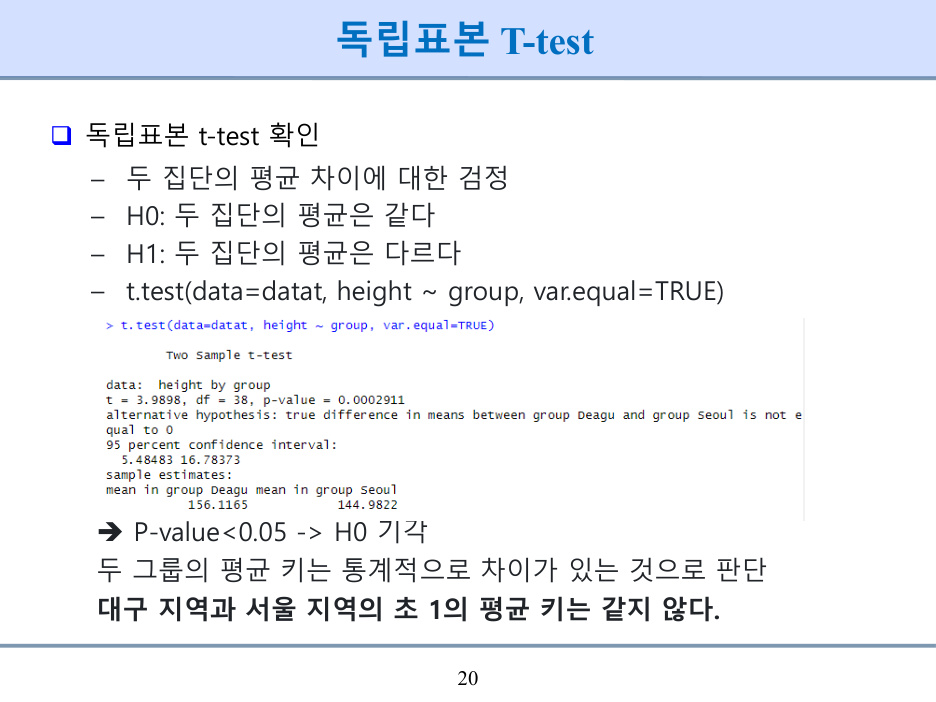
R t.test(y~group,data=d)는 기본적으로 Welch 방식이고 var.equal=TRUE를 지정하면 등분산 방식이다. 정규성 및 분산 점검과 실제 연구 설계를 함께 고려한다. Levene 검정의 큰 p값 역시 분산이 정확히 같다는 증명은 아니다.
Levene’s Test는 등분산성(Homogeneity of Variance)을 살펴본다. 실습은 lawstat 패키지의 levene.test(datat$height, datat$group, location="mean")를 사용하며 p=.1742다. 설치 install.packages("lawstat")와 불러오기 library(lawstat)는 서로 다른 단계다.
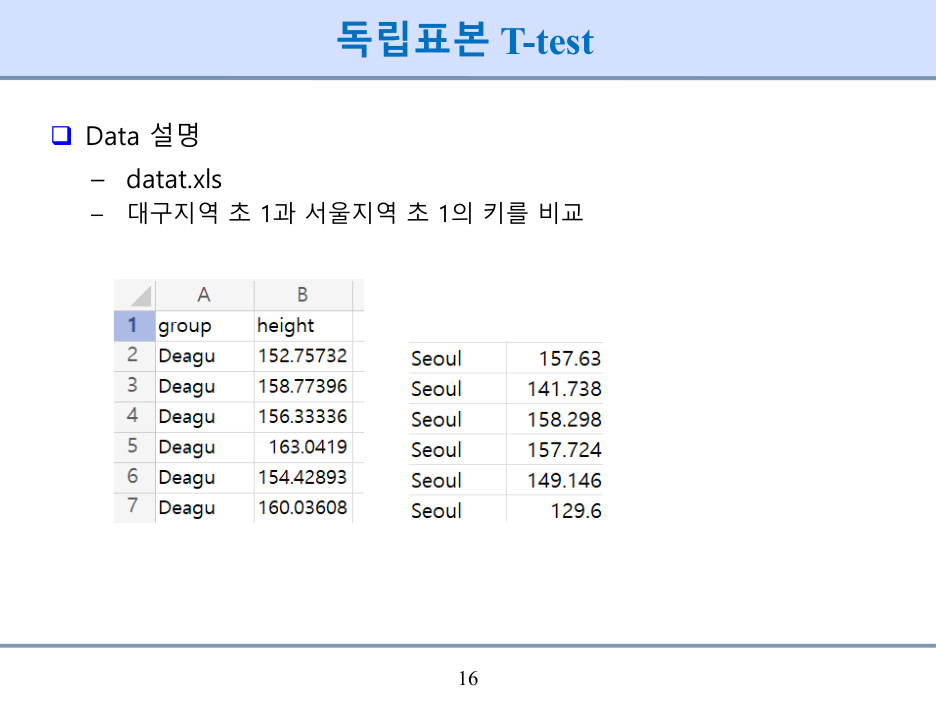
등분산 독립표본 결과는 t=3.9898, df=38, p=.0002911이다. 두 평균 156.1165와 144.9822의 차이를 비교하며, 차이의 95% 신뢰구간은 5.48483–16.78373이다. 검정 결과의 부호는 어느 집단에서 어느 집단을 뺐는지와 연결한다.
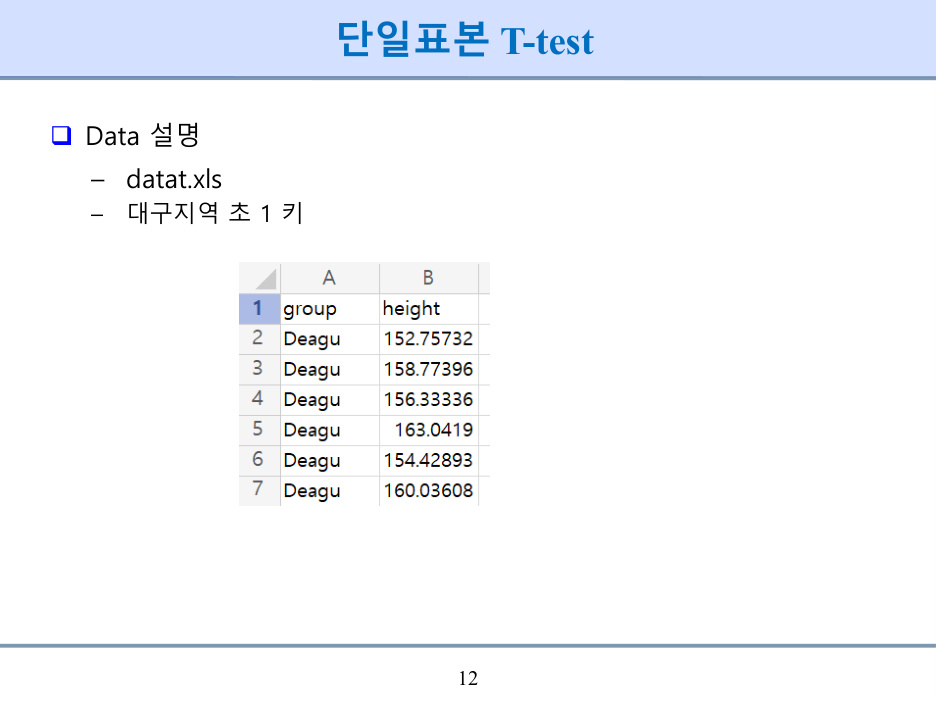
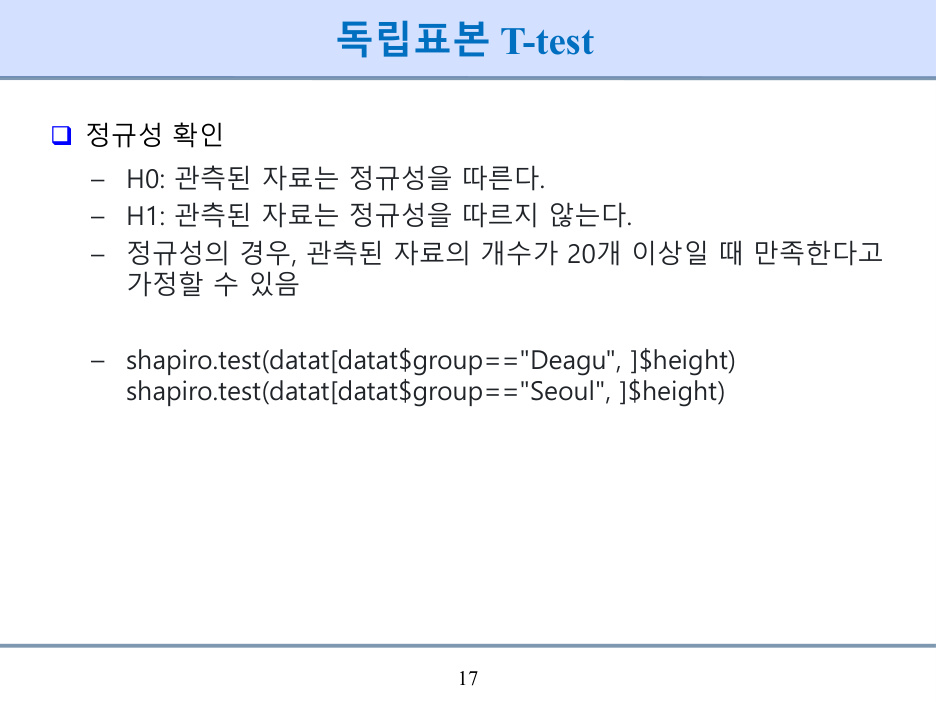
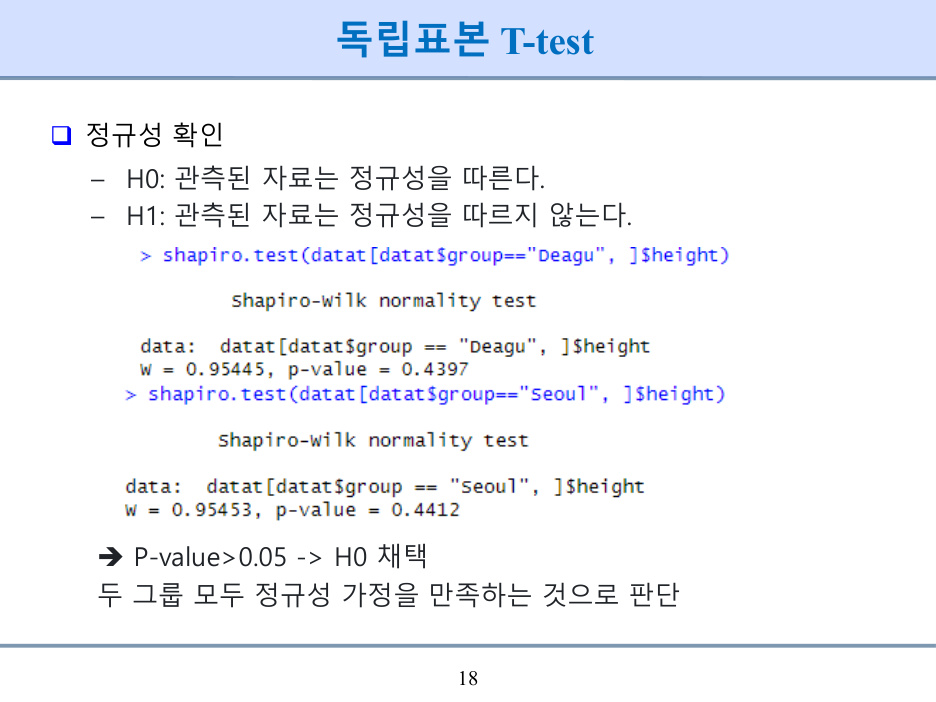
독립표본의 정규성 점검에서는 두 집단을 합쳐 한 번만 검사하는 대신 각 집단의 자료를 구분한다. 실습 화면은 datat[datat$group=="Deagu", ]$height와 datat[datat$group=="Seoul", ]$height를 각각 shapiro.test에 넣는다. 표시된 대구 결과는 W=.95445, p=.4397이고 서울 결과는 W=.95453, p=.4412이다. 두 결과 모두 유의수준 .05에서 정규성 가설을 기각할 근거가 부족하다는 뜻이다. 문자열 Deagu는 화면의 실제 데이터 표기이므로 자료의 집단명과 일치시켜야 한다.
관련 강의자료 펼치기
data_분석_t_test · PDF 물리 15쪽
data_분석_t_test · PDF 물리 16쪽
data_분석_t_test · PDF 물리 17쪽
data_분석_t_test · PDF 물리 18쪽
data_분석_t_test · PDF 물리 19쪽
data_분석_t_test · PDF 물리 20쪽
관련 영상 00:33:55 (원본 영상 · 로컬 보관)
관련 영상 00:38:06 (원본 영상 · 로컬 보관)
관련 영상 00:38:15 (원본 영상 · 로컬 보관)
관련 영상 00:37:13 (원본 영상 · 로컬 보관)
대응표본: 차이의 평균 검정
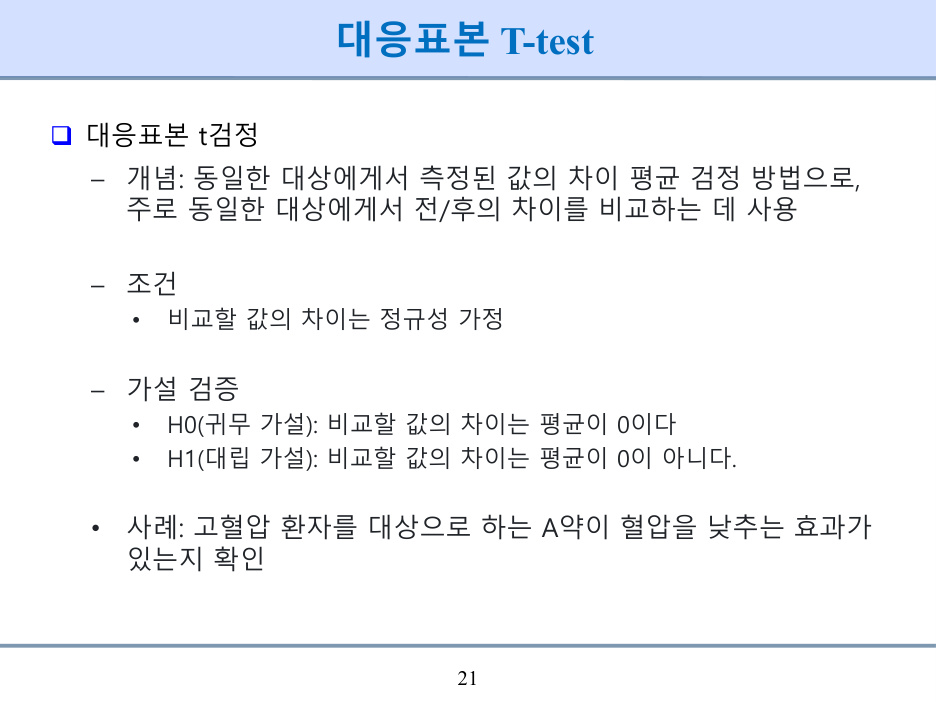
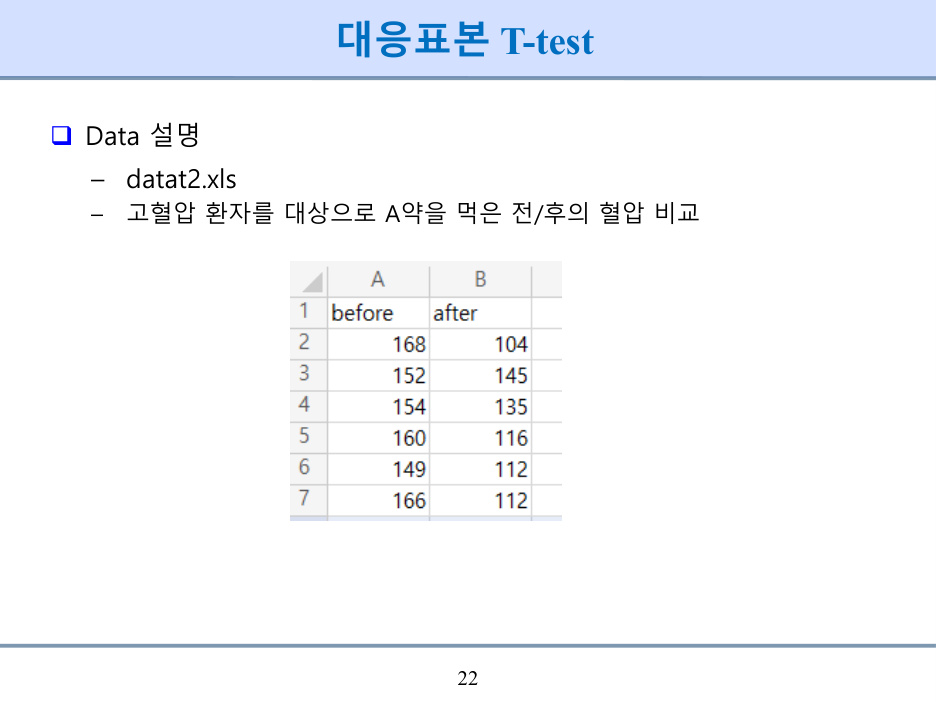
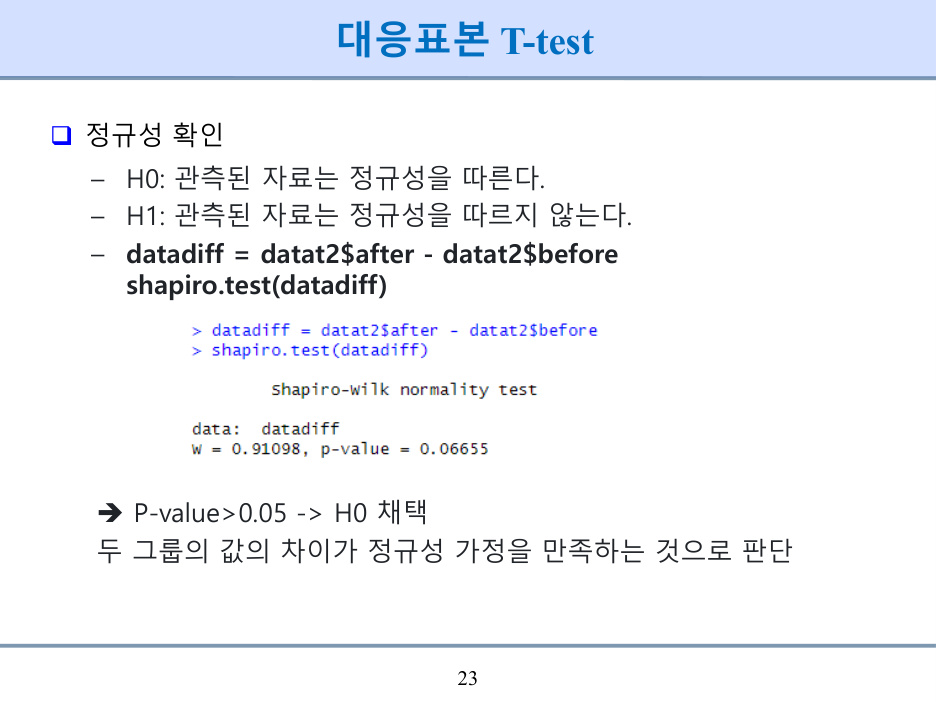
같은 사람의 전후 측정은 쌍을 유지한 차이 d=after−before를 분석한다. 귀무가설은 차이의 모집단 평균이 0이라는 것이다. 정규성 점검의 대상도 각 시점이 아니라 차이 벡터다.
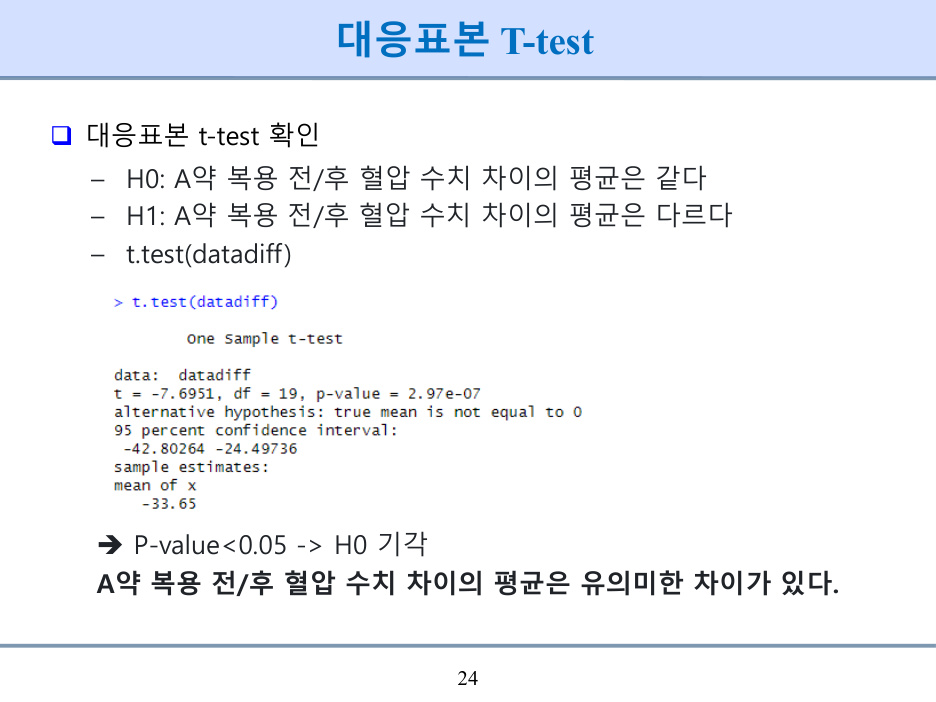
R에서는 t.test(after,before,paired=TRUE) 또는 t.test(after-before,mu=0)을 쓸 수 있다. 음의 평균차이는 after가 작다는 뜻이다. 차이 방향을 뒤집으면 t와 신뢰구간의 부호가 바뀌지만 양측 p값은 같다.
차이 after−before의 Shapiro–Wilk 결과는 W=.91098, p=.06655다. 대응표본 출력은 t=−7.6951, df=19, p=2.97×10⁻⁷, 평균차이=−33.65, 95% 신뢰구간=−42.80264–−24.49736이다. 이 수치는 해당 실습 자료의 결과이며 다른 대상의 효과 크기로 대입하지 않는다.
관련 강의자료 펼치기
data_분석_t_test · PDF 물리 21쪽
data_분석_t_test · PDF 물리 22쪽
data_분석_t_test · PDF 물리 23쪽
data_분석_t_test · PDF 물리 24쪽
관련 영상 00:42:11 (원본 영상 · 로컬 보관)
관련 영상 00:44:53 (원본 영상 · 로컬 보관)
핵심을 내 말로 정리하기
- 평균은 합을 관측값 수 n으로 나눈 값이다.
- 중앙값은 정렬한 자료의 가운데 위치를 기준으로 한다.
- R의 var는 표본분산 계산에서 n−1 분모를 쓴다.
- 표준편차는 분산의 제곱근이다.
- t검정은 평균에 관한 가설을 검토한다.
- 정규성 검정에서 p>.05는 정규성이 입증됐다는 뜻이 아니다.
- 단일표본 t검정에서는 비교할 평균 mu를 명시해야 한다.
- p값은 음수가 될 수 없다.
- 독립표본과 대응표본은 관측의 관계로 구분한다.
- Welch t검정과 등분산 t검정은 분산 조건 처리 방식이 다르다.
- 대응표본 검정에서 정규성 검토 대상은 대응 차이다.
- 차이의 방향을 뒤집으면 평균차이와 t통계량의 부호가 바뀐다.
이해했는지 확인해 보기
먼저 답을 생각한 뒤 문제를 눌러 풀이와 비교하세요.
1. 평균은 합을1/n으로 나눈 값이다. 이 설명의 문제점은?
n으로 나누는 것과1/n로 나누는 것은 반대 연산이다.
2. 중앙값은 가장 큰 값과 가장 작은 값만 평균한 것이다. 이 설명의 문제점은?
짝수 표본에서는 가운데 두 값의 평균을 쓴다.
3. R의 var는 항상 n을 분모로 사용한다. 이 설명의 문제점은?
표본분산과 모집단 기술 분산의 분모를 구분한다.
4. 표준편차는 단위를 바꾸어도 숫자가 절대 바뀌지 않는다. 이 설명의 문제점은?
표준편차는 원래 변수와 같은 단위를 갖지만 단위 환산에 따라 값도 변한다.
이 차시에서 주의할 표현
- after−before 벡터가 실제 검정에 들어가는 값이다.
- 양측 p값은 같을 수 있지만 부호와 신뢰구간 방향은 달라진다.